
在編輯器裡打下 doc,下面立刻列出一排候選,document、DocumentFragment、DocumentTimeline 都在裡面;再多打一個字母變成 docu,建議清單又少了一些。那它為什麼知道要列哪些字呢?今天就來看看~
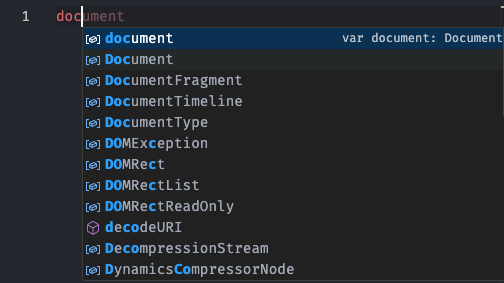
圖 1 在編輯器打下 doc 之後跳出的候選清單(資料來源:自行截圖)
先說一下,實際的編輯器還會替候選排序、也容忍打錯字,連開頭不是 doc 的 DOMException、decodeURI 都一起撈了進來,這裡先只看最基礎的問題:以這幾個字母開頭的字有哪些。
把這寫成程式,最直覺的版本大概是這樣。(編輯器那份字典太大,這裡先縮成一份四個字的小字典,要找的 doc 先縮成一個字母 a)
const words = ['are', 'as', 'at', 'rare'];

words.filter((word) => word.startsWith('a')); // ['are', 'as', 'at']
四個字的時候這樣寫完全沒問題,但真正的字典可能有十萬個字,filter 會把十萬個字全部走過一次,startsWith 再逐字元比對,而使用者每多打一個字母就要重問一次,之前查過的東西完全不能重用。之前提過,Hash Table 只在等值查找上快,需要範圍或排序的時候就得換別的結構,今天遇到的又是另一種問題,問題不是「這個字在不在」,而是「以這幾個字母開頭的字有哪些」。
今天要看的 Trie 就是用來處理這類問題,它把單字拆成一條由字母組成的路徑,開頭相同的字就共用同一段路。
前言那段 filter 走的是 Day 06 的 Linear Search,成本取決於字典有幾個字。那換成我們後面幾篇學過的結構,情況會不會好一點呢?
先試 Hash Table,把每個單字當成 key 建一張表,用 key 表示「這個字存在」:
const wordTable = {};
for (const word of ['are', 'as', 'at', 'rare']) {
  wordTable[word] = true;
}

wordTable['are']; // true
wordTable['a']; // undefined
問 are 在不在是平均 O(1),但 wordTable['a'] 拿到的是 undefined,而字典裡明明有三個字以 a 開頭,原因是這張表的 key 就是那四個完整的單字,a 不在裡面,它從來沒有被存進去過。所以「開頭是 a 的字有哪些」這問題,表上沒有一格可以直接去拿,只能把 key 全部倒出來再逐一比對開頭:
Object.keys(wordTable).filter((word) => word.startsWith('a')); // ['are', 'as', 'at']
而這正是前言那段 filter,繞了一圈又回到原地。
再試 Ordered Array,字典照字典序排好之後,以 a 開頭的那些字會全部連續排在一起,are、as、at 就是相鄰的三格。這和剛才的 Hash Table 剛好相反,hash 把開頭一樣的字打散,排序則把它們聚在一起,於是「開頭是 a 的字有哪些」變成一個看得到的區間:找到區間的第一個字,再往後一個一個讀,讀到開頭不是 a 的那個字就停。
找起點可以用 Day 06 的 Binary Search,成本是 O(log N)(這裡要找的是「第一個以 a 開頭的字」而不是某個特定的值,所以用的是它的變形)。這條路走得通,但 N 還留在成本裡,字典從十萬個字變成一百萬個字,找起點就要多比幾次。另外維護這份順序也要成本,插入一個新字要把後面的元素整批往後移,那是 O(N)。
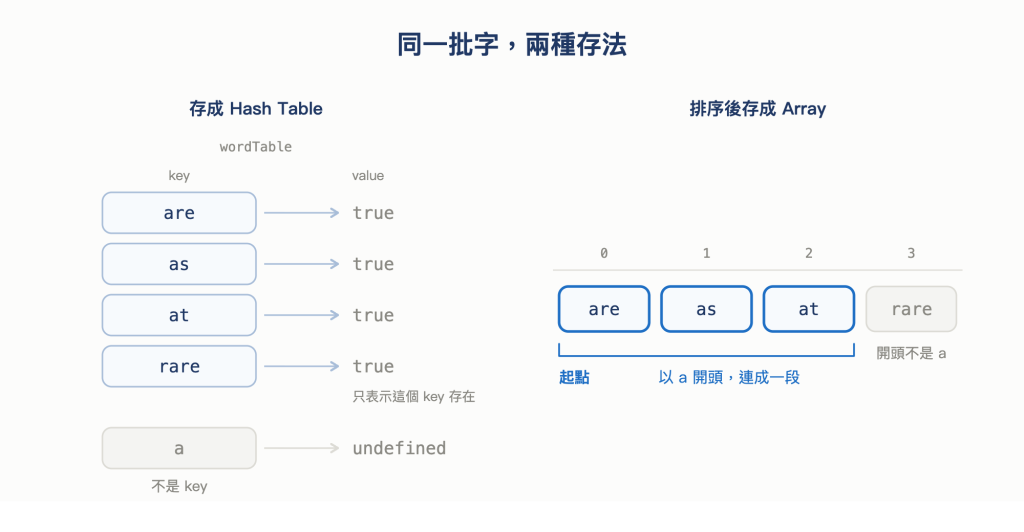
圖 2 同一批字,兩種存法
既然前面幾篇都在講 Tree,那把字典存進 Binary Search Tree 呢?字串之間也可以比大小,所以 BST 一樣建得起來。它維持的順序和 Ordered Array 相同,以 a 開頭的字在 inorder 走訪上會連續出現,也能從 root 開始找到這段區間的起點,成本是 O(h)。
比起 Ordered Array,BST 插入新字時不必把後面的元素整批移動,這點確實改善了,不過查找成本取決於整棵 Tree 的 height,不是只取決於要查的字首有多長;Tree 長得夠平衡時是 O(log N),歪掉時最壞還是 O(N)。
目前這幾個方法有個共同點,不論是拿去 hash、拿去比大小,還是拿去掛在 Tree 上,處理的單位都是整個字。既然要問的是開頭,那能不能讓開頭本身就是結構的一部分呢?
答案是可以,而這就是 Trie 的做法。一樣先給 Trie 一句話定義:
Trie 是一棵 Tree,每顆 node 記錄「下一個字母」,從 root 連起來的路徑代表字母序列,開頭相同的單字則共用同一段路徑。
另外,這篇會用一張 Hash Table 來存每顆 node 的下一個字母,程式裡叫它 children。
接著把 are、as、at、rare 放進去看一次。
放入 are:root 的 children 一開始是空的,所以程式讀到 a 時先建立一顆 node,再把 a 和這顆 node 存進 root.children。接著讀 r,在 a 那顆 node 的 children 建立 r;最後讀 e,再在 r 的 children 建立 e。三個字母都處理完後,root 底下就多了 a → r → e 這條路徑。
放入 as:程式先用 a 查 root.children,這次已經找得到剛才建好的 node,不用新增;接著查看看 a 的 children 有沒有 s,找不到才建立新 node。因此 as 只新增了 s,開頭的 a 直接和 are 共用。
放入 at:程式一樣能在 root.children 找到 a,只有第二個字母 t 不在 a 的 children 裡,所以這步只新增 t。
放入 rare:用第一個字母 r 查 root.children,找不到對應的 node,所以得另外建立 r → a → r → e 四顆 node。這條路徑和前面三個字完全不重疊。
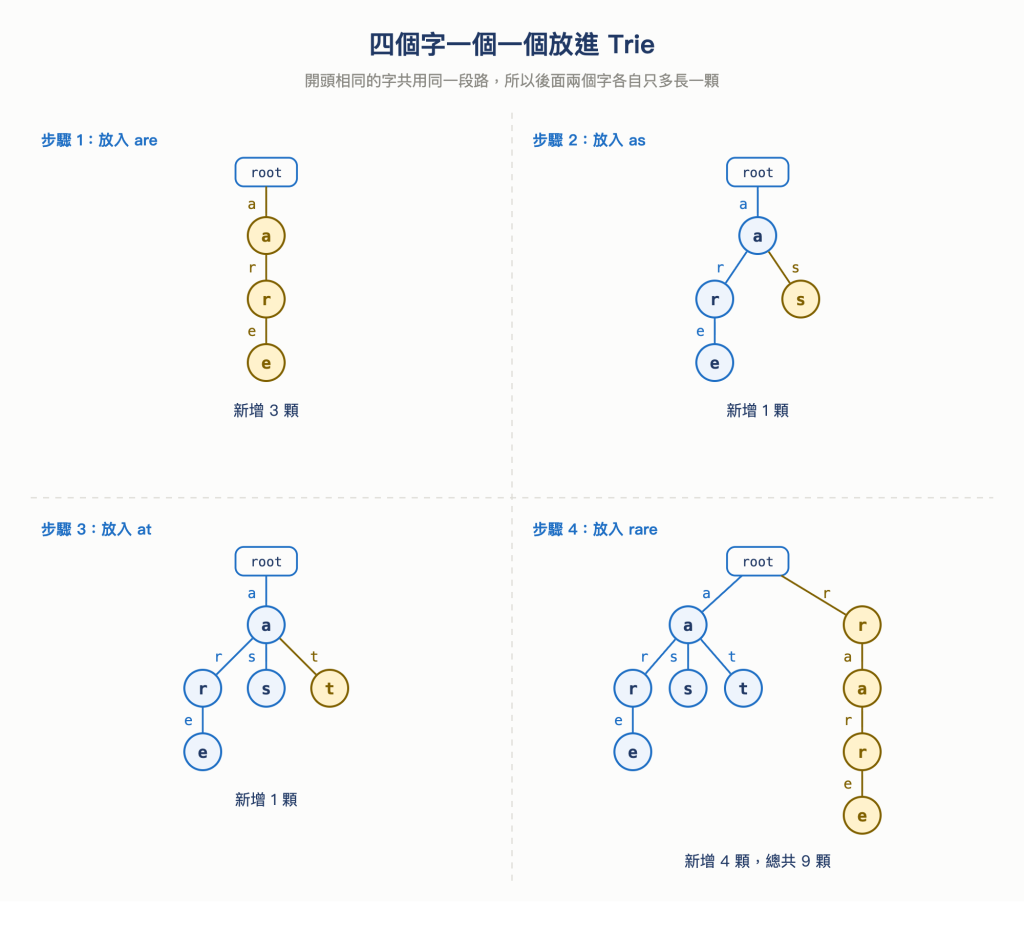
圖 3 四個字依序放進同一棵 Trie,as 和 at 因為共用開頭那顆 a,各自只新增了一顆 node
這也是 Trie 另一個名字的來源,Trie 又叫 prefix tree,因為單字的字首 (prefix) 會決定它和哪些單字共用路徑。are、as、at 共用的 a node,就是「共享字首」在結構上的樣子。
補充:
trie這個字怎麼來的、怎麼念
trie不是tree拼錯。這個名字是 Edward Fredkin 在 1960 年取的,取自 retrieval(檢索)的中間音節。也因為這個來源,Fredkin 自己把它念成和 tree 相同的音;但後來不少人改念成和 try 相同的音,好在講話時和 tree 區分開來。兩種念法都有人用。
用 Hash Table 存每顆 node 的下個字母是什麼意思呢?
Day 20 的 BST node 只需要 left 和 right 兩條 link,但在 Trie 裡,一個字母後面可能接 a 到 z 中的任何一個字母,兩條固定的 link 不夠用。
因此這篇讓每顆 Trie node 都帶著一張 children Hash Table,key 是接下來可能出現的字母,value 是那個字母對應的 child node。例如剛才那顆 a,它的 children 有 r、s、t 三個 key,就代表從這裡開始,下一個字母可以是 r、s 或 t。
root 是全部單字共同的起點,它自己不代表任何字母,而要查一段字串時,程式先站在 root,拿第一個字母查 root.children;找到對應的 child 後,再拿第二個字母查那顆 node 的 children,一個字母接著一個字母重複查詢。後面會說「沿著字母路徑往下」,程式上做的就是這串 children 查找。
拿剛才那棵 Trie 查一次 are,過程會是下面這樣:
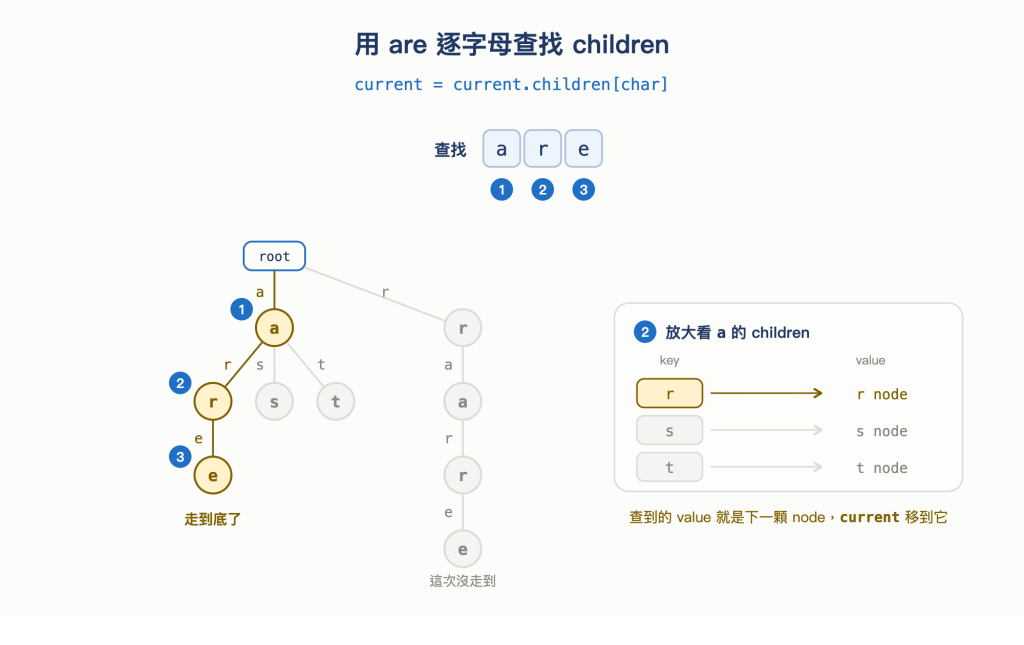
圖 4 搜尋 are 時,程式每次用一個字母查 current.children,再把 current 移到查得的 child node
四個字都放進去後,先拿 a 來查,程式從 root 開始,用 a 查找對應的 child,確實找得到;再拿 ra 來查,程式也能從 root 依序找到 r、a 兩顆 node。這代表 Trie 裡有 a 和 r → a 這兩段路徑,卻不代表字典裡有 a 和 ra 這兩個完整的字。它們只是 are、as、at 與 rare 的開頭。
可以找完一條路徑,只能說明這段字母是某些單字的字首;要判斷它自己是不是完整單字,還得另外想辦法。做法是讓每顆 node 帶一個標記,插入單字時,只在最後一個字母對應的 node 上把標記打開,其他 node 保持關著。這樣 are 最後的 e、as 的 s、at 的 t,以及 rare 最後的 e 這四顆 node 會打開標記,其他 node 則不會。
這標記有不同寫法,《A Common-Sense Guide to Data Structures and Algorithms》是在單字結尾那顆 node 的 children 裡多放一個特殊的 * key;這篇則在 node 上放一個 isEndOfWord 布林值。兩種寫法處理的東西相同,到這裡時,前面的字母已經組成一個完整單字。
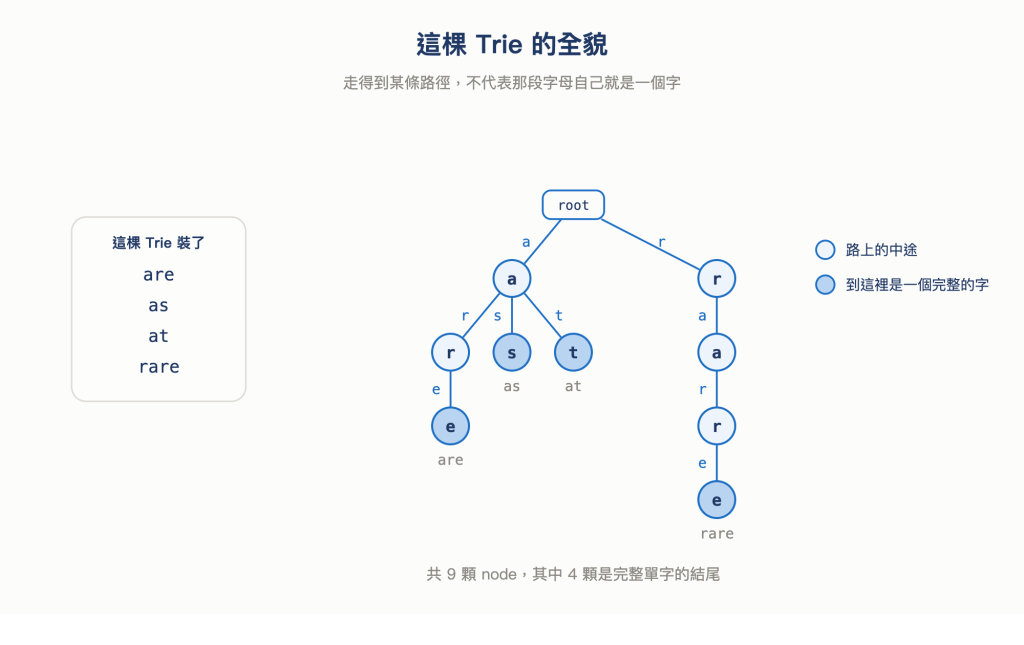
圖 5 四個字放進同一棵 Trie,are、as、at 共用開頭那顆 a,而完整單字的位置要另外標記
還有種情況也需要這標記,目前這四個字有個巧合:每顆打開標記的 node 底下都剛好沒有 child,看起來只要問「這顆 node 還有沒有 child」就能判斷是否為完整單字,不必另外存東西。但只要字典裡再多個 ate,這想法就會失效,at 的那顆 t 會多出一個 child e,而 at 自己仍然是一個完整的字。一顆 node 可以同時是某個字的結尾、又是另一個更長的字的中途,這就是標記不能用「有沒有 child」代替的原因。
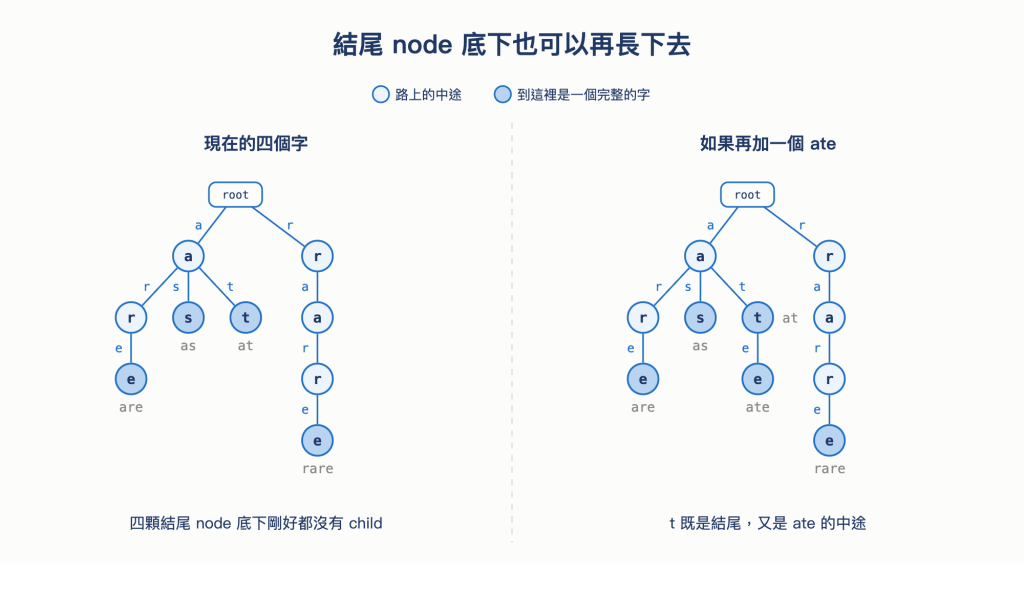
圖 6 只要字典裡多一個 ate,at 那顆 t 就同時是完整單字的結尾和更長單字的中途
現在一顆 Trie node 要保存的東西已經到齊了:一張「下一個字母到 child node」的 children,以及一個「這裡是不是單字結尾」的 isEndOfWord。寫成 class 如下:
class TrieNode {
  constructor() {
    this.children = {}; // key 是字母、value 是那個字母對應的 child node
    this.isEndOfWord = false; // 只有單字最後一個字母那顆會被改成 true
  }
}

class Trie {
  constructor() {
    this.root = new TrieNode();
  }
}
Trie 本身只需保存 root,其他 node 都能從 root 的 children 找到。root 也是一顆 TrieNode,只是它的 isEndOfWord 永遠保持 false。
接下來的示意圖會把字母同時標在兩個地方:edge 上那個對應程式裡的實情,字母是 parent children 的 key;node 裡那個只是方便閱讀時定位,TrieNode 本身並沒有保存自己的字母。
再來看看 Trie 的不同操作,先看插入~
插入時,current 先指向 root,程式再依序處理單字的每個字母。如果 current.children 裡已有這個字母,就讓 current 指向對應的 child;如果沒有,就先新增一顆 node 再移過去。所有字母都處理完後,最後停下來的那顆 node 就是單字結尾,把它的 isEndOfWord 改為 true:
insert(word) {
  let current = this.root;

  for (const char of word) {
    if (current.children[char] === undefined) { // 沒有這個字母,才開一顆新的
      current.children[char] = new TrieNode();
    }
    current = current.children[char];
  }

  current.isEndOfWord = true;
}
拿 are 和 as 對照這段程式看看流程,插入 are 時 Trie 還是空的,所以三圈都走同一邊,每一圈都新增一顆 node。as 才是有看頭的那一個,它兩圈各走了 if 的不同一邊:
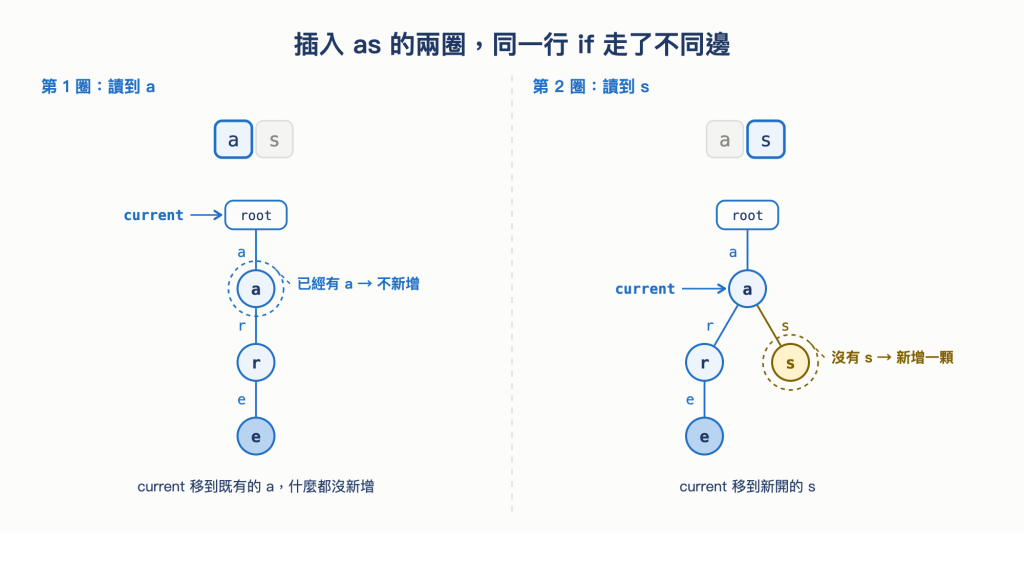
圖 7 插入 as 的兩圈,第 1 圈沿用既有的 a、第 2 圈才新增 s
時間複雜度上,令 L 代表這個單字的長度,迴圈就跑 L 圈,每一圈是一次 children 查找加上最多一次建立 node,兩件事都是 O(1),最後打開標記也是 O(1),所以插入是 O(L)。
搜尋也是從 root 開始,依序用每個字母查找下一顆 child。差別在於,插入遇到不存在的 child 會建立新 node,搜尋遇到同樣情況則直接回傳 null:
search(prefix) {
  let current = this.root;

  for (const char of prefix) {
    if (current.children[char] === undefined) return null;
    current = current.children[char];
  }

  return current; // 回傳走到底那顆 node,不是 true,autocomplete 還要從它往下走
}

contains(word) {
  const node = this.search(word);
  return node !== null && node.isEndOfWord;
}
這裡刻意拆成兩個函式,因為同一段查找過程可以回答兩個不同的問題。search 回答「這段字母形成的路徑存不存在」,因此它回傳最後找到的那顆 node,而不是 true。那顆 node 底下的 subtree,正好包含以這段字母開頭的所有單字。contains 回答的是「這是一個完整的字嗎」,它在 search 的結果上再檢查 isEndOfWord。
用主例那棵 Trie 跑三個例子:
contains('at'):程式依序找到 a、t 兩顆 node,而最後的 t 有打開標記,所以回傳 true
contains('ra'):r → a 這段路徑存在,但最後的 a 沒有打開標記,代表 ra 只是字首,回傳 false
contains('cat'):root.children 裡沒有 c,所以 search 第一圈就回傳 null,contains 最後得到 false
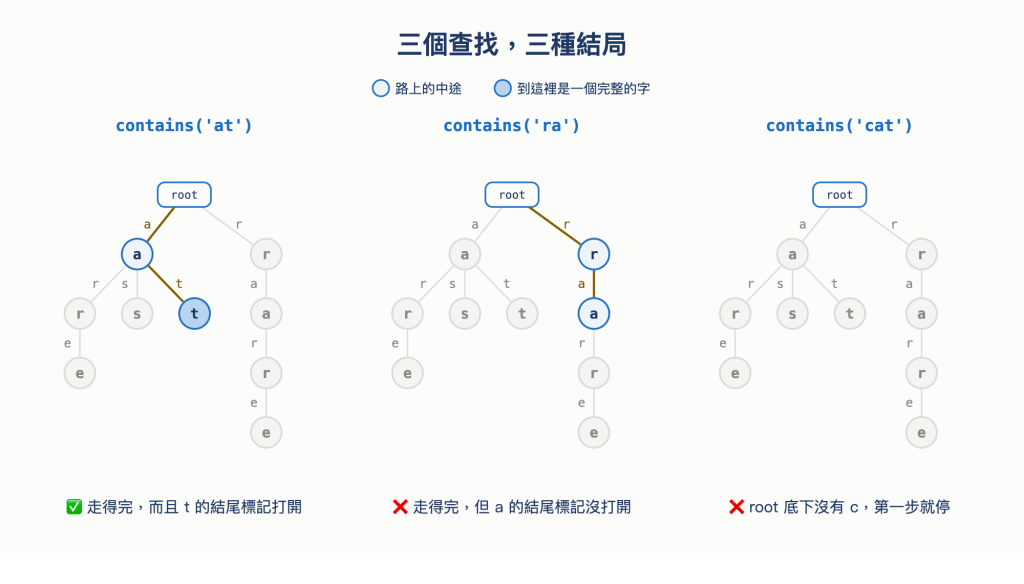
圖 8 三個查找的三種結局:走得完且標記打開、走得完但標記沒打開、第一步就走不下去
O(單字長度),不是 O(N)搜尋 rare 時,current 一開始指向 root,程式讀取 r 後查到第一顆 child,再依序用 a、r、e 查下一顆,總共查四次,剛好就是 rare 的四個字母。
這裡的重點是,第一次查到 root 底下的 r 之後,程式接下來只會繼續查 r 這條分支的 children,root 底下另一條 a 分支根本不會進入這趟走訪,are、as、at 三個字都不必檢查。字典換成十萬個字也一樣,只要那些字不在 r → a → r → e 這條路徑上,這次搜尋就不會碰到。
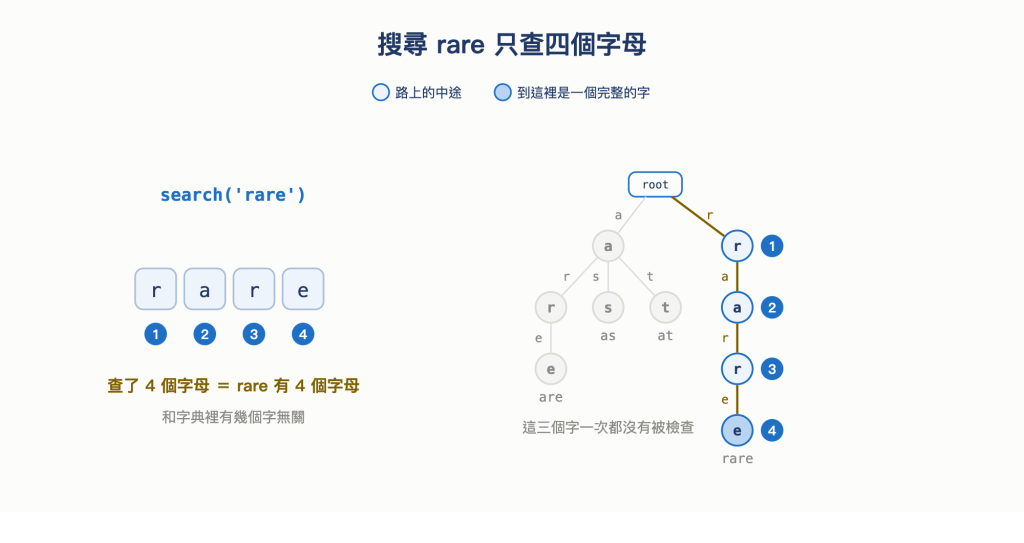
圖 9 搜尋 rare 只需要查四個字母,另一條分支上的三個字都不必檢查
因此搜尋的成本是 O(L),取決於要查的單字長度,而不是 O(N) 取決於字典裡有幾個字。找不到時還可能更早結束,例如前面的 contains('cat') 第一次就在 root.children 查不到 c,所以 L 只是這趟搜尋的上界,不一定每次都會查滿 L 個字母。
和前面的結構對照,Ordered Array 從十萬個字增加到一百萬個字時,Binary Search 要多比幾次;Trie 裡不論另外加了多少個字,查 rare 最多還是處理四個字母。
為什麼處理一個字母可以算 O(1)?因為 children 用的是 Hash Table,只要 hash function 能適當打散 key、load factor 也維持在合理範圍,用字母查一顆 child 平均就是 O(1)。
把第 2 節試過的那幾條路和 Trie 放在一起看,差別如下:
| 做法 | 怎麼定位到以某段字首開頭的字 | 定位的成本 |
|---|---|---|
| Unsorted Array | 逐一檢查每個字的開頭 | O(N) |
| Ordered Array | Binary Search 找到那段區間的起點 | O(log N) |
| Binary Search Tree | 從 root 走到那段區間的起點 | O(h) |
| Hash Table | hash 的是完整單字,用字首算不出它們的位置 | O(N),得把所有 key 走一遍 |
| Trie | 用字首的每個字母依序查找 child | O(L) |
N 是字典裡有幾個字、h 是 Tree 的 height、L 是要查的字首長度。這張表比的是「定位」那一段,也就是搞清楚符合的字在哪裡,而前四種結構的成本仍受整份字典的筆數或 Tree 形狀影響;Trie 這段則只取決於字首長度。
定位後,所有做法都避不掉產生輸出的成本,但處理方式不完全相同,Ordered Array 可以直接讀取連續的完整字串;Trie 則要走訪匹配的 subtree,把沿路的字母組成單字。
O(h) 和 O(L) 這兩個數字的來源不同。Day 20 提過,Binary Search Tree 的 height 受插入順序影響,同一批資料換個順序插入,可能從平衡的 Tree 變成歪斜的 Tree,搜尋成本從 O(log N) 退化成 O(N)。
Trie 的形狀則由單字本身決定,例如 rare 最後的 e 只可能接在 r → a → r 後面,不論 rare 是第一個還是最後一個插入,最後都會在同個位置。插入順序只影響各條分支建立的先後,不影響最後的形狀。
整棵 Trie 的最大深度由最長的單字決定,不會因為插入順序不同而歪成一條線。因此 Trie 的 O(L) 不必附帶「結構要夠平衡」的條件,也不需額外平衡機制。
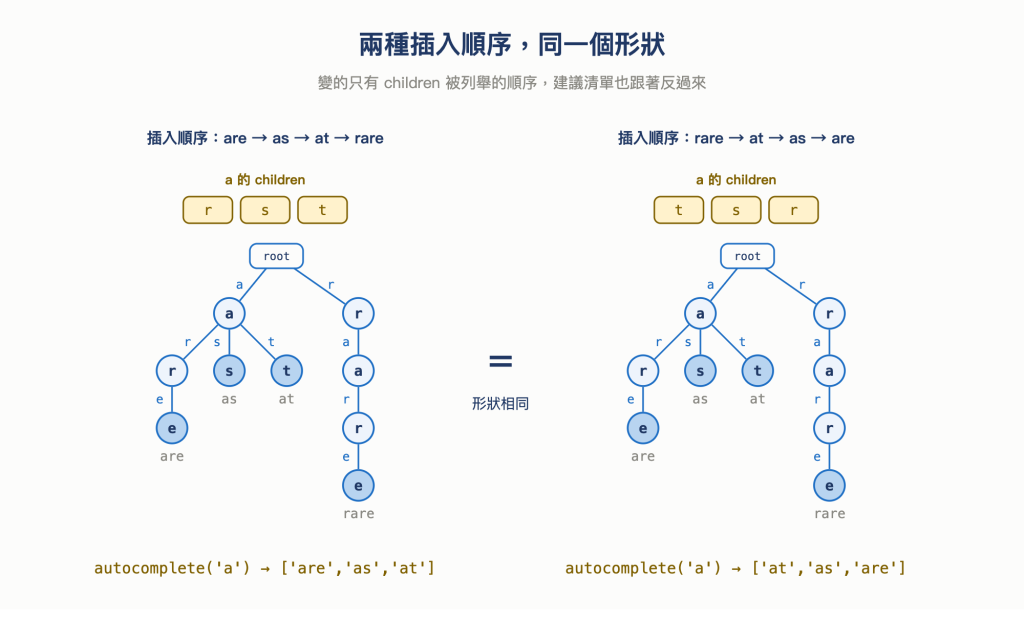
圖 10 兩種插入順序,同一個形狀
回到前言 autocomplete 的情境~假設使用者打了 a,要列出以 a 開頭的所有字。第一步就是剛才的 search('a'),它會回傳 a 那顆 node,但那顆 node 本身沒有存任何單字,要列的建議在它底下那片 subtree 裡,因此還得再做些事,以下就來看看!
做法是走訪那片 subtree,每走到一顆標記打開的 node,就把一路累積下來的字母收成一個字。這是之前提過的 preorder 走訪,先處理自己再往下走,只是 child 的數量這次不固定,要用迴圈跑過 children;遞迴的寫法則和 Day 13 一樣:
collectWords(node, prefix, words) {
  if (node.isEndOfWord) words.push(prefix);

  for (const char of Object.keys(node.children)) {
    this.collectWords(node.children[char], prefix + char, words);
  }

  return words;
}

autocomplete(prefix) {
  const node = this.search(prefix);
  if (node === null) return [];

  return this.collectWords(node, prefix, []);
}
autocomplete('a') 可以拆成下面幾步:
search('a') 先回傳 a 對應的 node,collectWords 就從這裡開始a 的 isEndOfWord 是 false,所以 a 自己不收進結果。接著檢查它的三個 child:r、s、t
r,傳給下一層的字串變成 ar。r 不是單字結尾,所以再處理它底下的 e;這時字串變成 are,而 e 的標記是 true,因此把 are 收進結果r 這條分支後,回到 a 那層,再處理 s 和 t,分別收進 as 與 at
最後得到 ['are', 'as', 'at']。rare 不會被檢查,因為它在 root 底下的 r 分支,不在這次從 a 開始走訪的 subtree 裡。
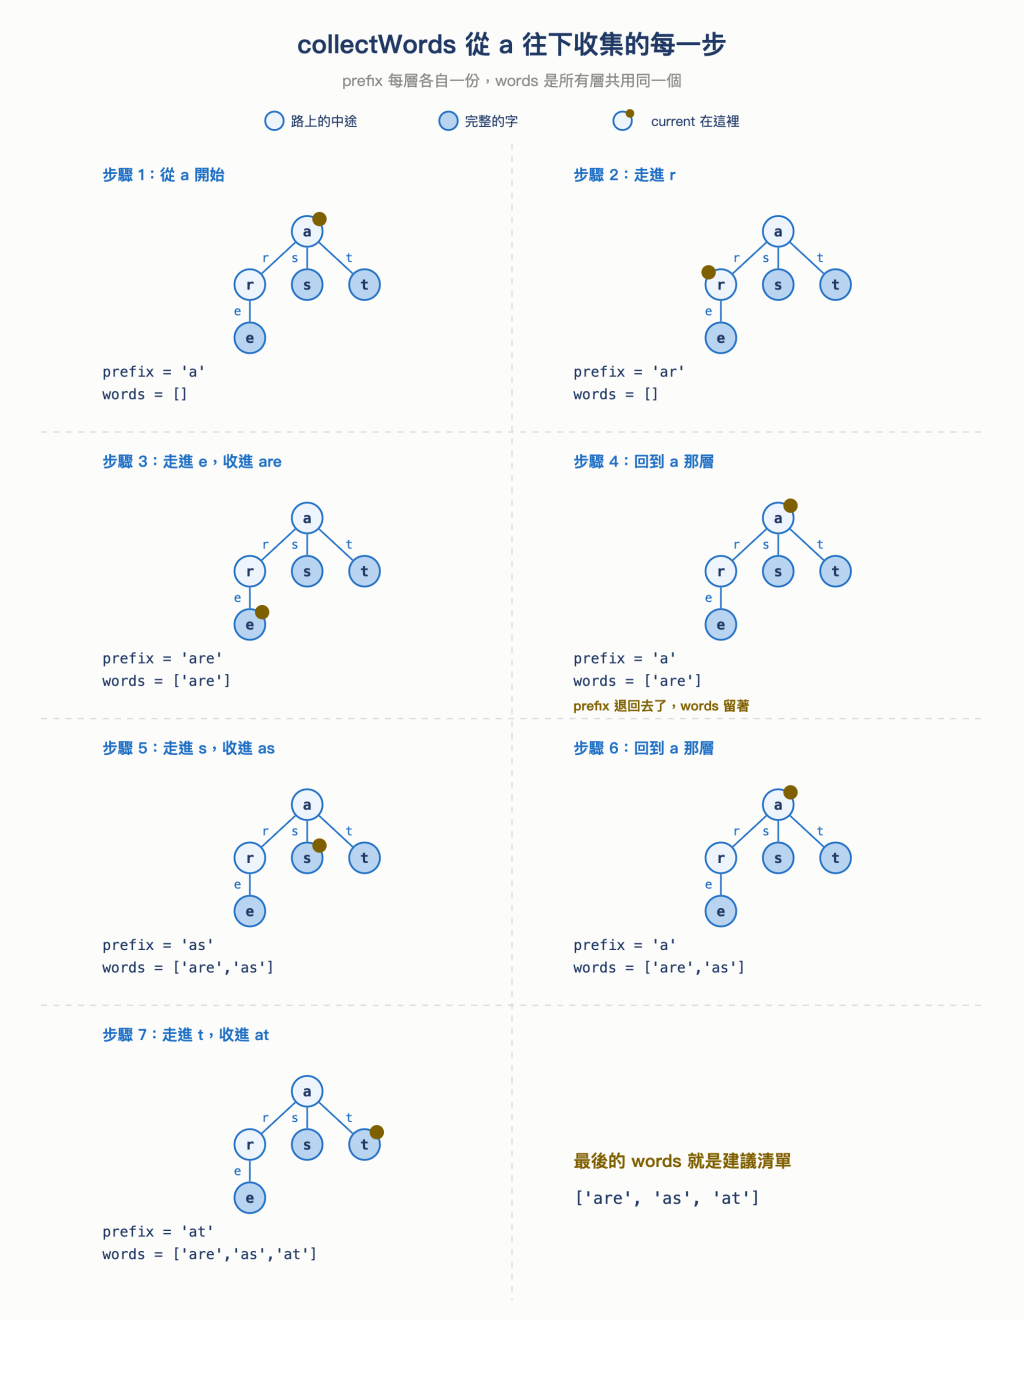
圖 11 從 a 往下收集的過程,prefix 回到上一層就退回去、words 則一路留著,最後的 words 就是建議清單
這裡的 ['are', 'as', 'at'] 還有一個細節:程式照 Object.keys(node.children) 給出的順序走,而那順序和 children 被建立的順序相同,也就是單字插入的順序(Day 07 提過,只有看起來像整數的 key 會被改成照數值排,本篇的 children 全是字母,不會踩到)。前面提過插入順序不影響 Trie 的形狀,它影響的是這裡,同樣這四個字改成從 rare 開始倒著插入,形狀一模一樣,但 a 的 children 會變成 t、s、r,建議清單也跟著反過來。因此結果的順序取決於 children 怎麼被列舉,不是 Trie 自動保證的字典序。如果要字典序,可以先對 children 的 key 排序;如果要像編輯器一樣按相關性排建議,則還要另外保存分數或使用頻率等資訊。
prefix 又是 a另外補充一段,收完 are 後,程式要回到 a 那層再處理 s,這時 prefix 必須是 a,不能是 are。但程式裡並沒有任何一行把 are 改回 a,因為它根本不需要改。
prefix + char 每次都會算出一個新字串,再把新值傳給下一層。因此 a 那層的 prefix 始終都是 a,往下傳的 ar 屬於下一層,are 又屬於更下一層。處理完 are 後,底下兩層的函式呼叫結束,程式回到原本那層,拿到的自然還是它自己的 a。這就是 Day 13 說的,call stack 上每一層 frame 都各自保管自己那份參數。
words 剛好相反,各層收到的是同一個陣列,are 加進去後會留在裡面,接著找到的 as、at 也會加進同一個陣列。這和 Day 13 的累加器不太一樣,那裡的 acc 每層拿到的是一個新算出來的值,和這裡的 prefix 同一種。
因此,同個遞迴裡有兩種狀態:prefix 是每層各自一份,words 則是所有層共用同個陣列。
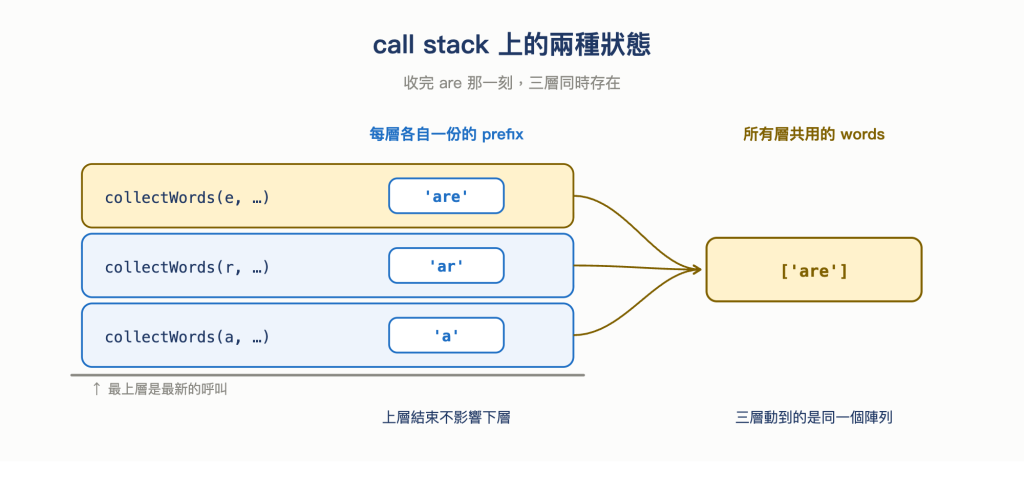
圖 12 收完 are 那一刻的 call stack,三層各有自己的 prefix,卻共用同一個 words
找到字首 node 是 O(L),但列出建議還要走訪它底下的 subtree,並把路徑上的字母組成輸出字串。autocomplete 的總成本因此是 O(L) 再加上這段走訪與產生輸出的成本:匹配的字越多、剩下的路徑越長,第二段就越大。如果只需要前幾個建議,就不必走完整片 subtree,取到夠用的數量就可以停。
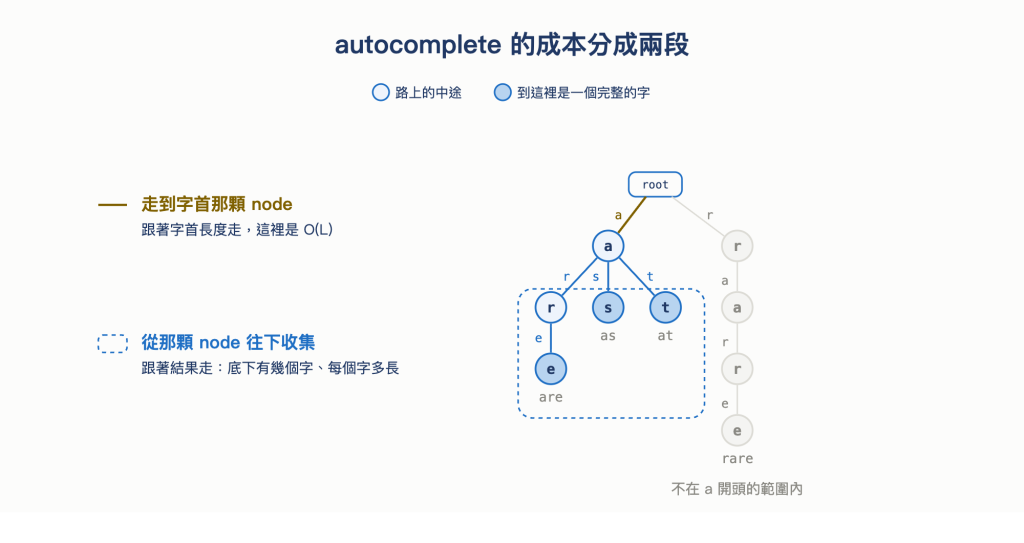
圖 13 autocomplete 的成本分成兩段
前言那段 filter 程式還有個問題,使用者每多打一個字母,程式就要重新檢查整份字典。Trie 則可以保留上一次查詢的位置,使用者打 a 時,程式停在 a 對應的 node;接著多打一個 r,只要用 r 查這顆 node 的 children,就能從 a 移到 ar 的位置,不必再從 root 重查 a。
前面的 search 每次都從 this.root 出發,因為它是一個完整、獨立的搜尋函式。在實際的連續輸入情境中,只要另外保存目前的 node,新增一個字母時就只需查一次 child。
按 backspace 時則要看程式額外保存了什麼。如果只留目前的 node,因為 TrieNode 只有 children、沒有指回 parent 的 link,程式就得從 root 重新查較短的字首。另外還有種做法是把沿路的 node 存進一疊 Stack:多打一個字母就 push,按 backspace 時就 pop,這樣不用改 TrieNode 的結構,也能回到上一顆 node。
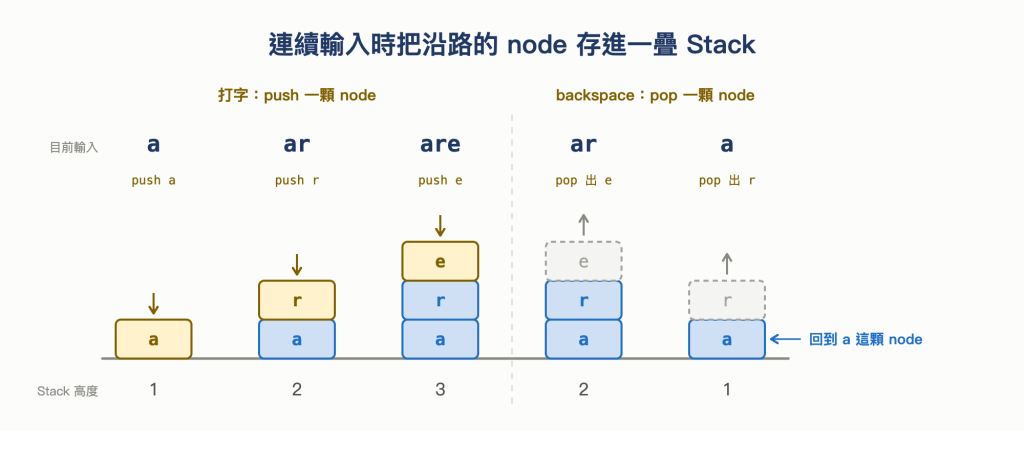
圖 14 連續輸入時把沿路的 node 存進一疊 Stack
回到圖 1 那份自動補全的推薦清單~編輯器列出來的候選是排過序的,而目前的 autocomplete 只按走訪順序回傳。要讓建議有優先次序,得多存一個資料,也就是每個單字的分數(或說權重),例如它被選用的次數。
這資料要存在哪呢?剛好可存在結尾的標記,isEndOfWord 現在是布林,只回答「這裡是不是一個字」;把它換成「一個分數,或是 null 代表不是字」,同欄位就能同時回答兩件事。收集時把分數一起收下來,最後照分數排序,只回傳前幾個。
不過這無法改變走訪的成本,要知道哪幾個分數最高,還是得把那片 subtree 走完,省下來的是輸出的數量,不是走訪的步數。真的要連走訪一起省,就得在每顆 node 上再存「我底下最高的分數是多少」,那已經是另一種設計了。
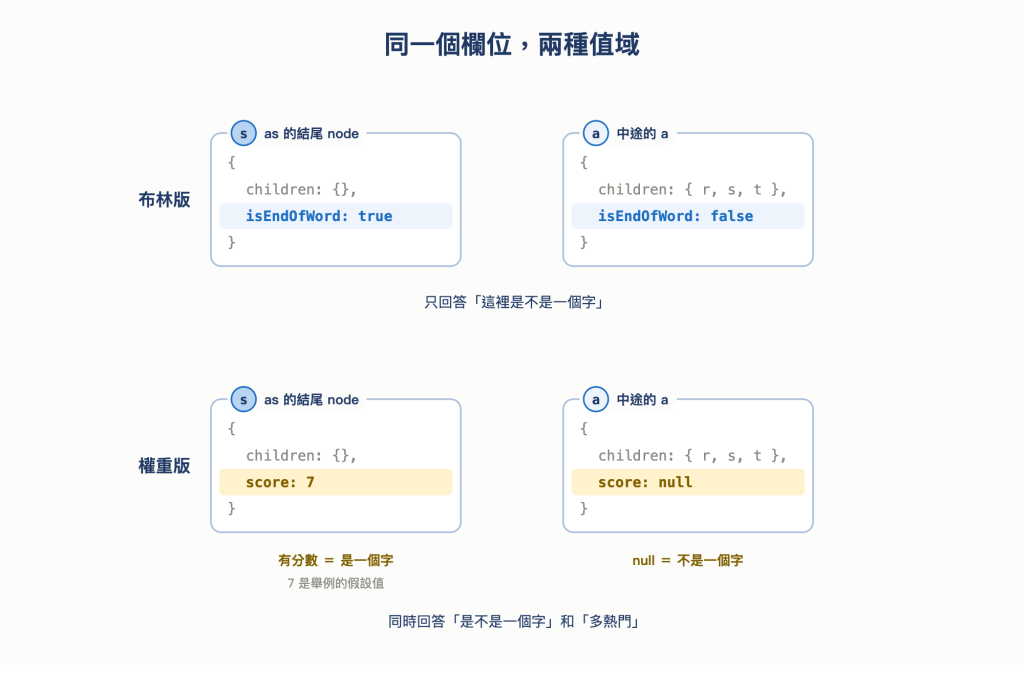
圖 15 權重版只換掉一個欄位,isEndOfWord 的布林值換成「一個分數,或是 null」,children 完全不變
先看省下的,如果四個字各自長成一條獨立的路徑、開頭完全不共用,are 要 3 顆 node、as 和 at 各 2 顆、rare 4 顆,總共 11 顆;共享之後,are、as、at 那邊變成 a、r、e、s、t 五顆,加上 rare 那條四顆,總共 9 顆。省下來的兩顆就是 as 和 at 沒有再各自存一次的那個 a。字典越大、開頭重疊得越多,省下的比例就越高,十萬個英文字裡以 a 開頭的那一大批,全部共用同一顆 node。
不過這 9 顆 node 也不是白拿的。剛才比的是共享前後的 Trie,而如果拿 Trie 和「把四個字直接排成一列」比,代價就出現在每一顆 node 身上:每顆 node 都要帶一份 children,即使它只有一個 child 也一樣要帶,而一張 Hash Table 佔的空間比一個字母大得多。rare 那條路上的四顆 node 沒有一顆和別的字共用,卻每一顆都付了這份開銷。因此,若字典裡的字共享得很少,Trie 佔的空間有可能比直接把字排成一列還多。
字母集合大小會造成多少額外開銷,要連同 children 的實作一起看。如果每顆 node 都用固定長度的 Array,小寫英文字母就是每顆準備 26 格,字母集合越大,每顆 node 的空格開銷就越大。這樣做換到的是取用方式,字母可以直接算成格號(children[c - 'a']),連 hash 都不必算。但這篇使用的是 Hash Table,它只存實際存在的 child,所以字母集合變大,不代表每顆 node 都要預留整個字母集合的空間;這時主要付的是每顆 node 一張 Hash Table,以及實際 children 條目的開銷。換句話說,Trie 是拿「每顆 node 一份 children」的空間,換掉「搜尋成本跟著字典大小走」這件事。
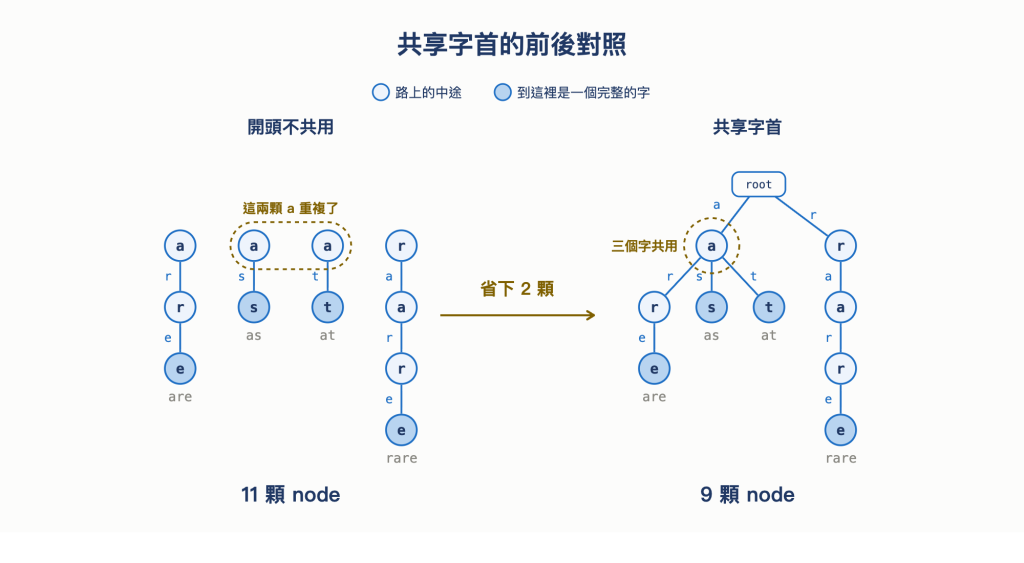
圖 16 同樣四個字,開頭不共用要 11 顆 node,共用之後是 9 顆
使用者打錯字時,如果希望得到一些提示,程式該怎麼提出建議呢?直覺的答案是「最像的那一個」,但「像」很難定義成程式看得懂的東西。以 Trie 來看,意思是字典裡和他打的那個字共同開頭最長的是哪一個。
autocorrect 拿使用者打的字沿著 Trie 往下走,走到走不下去為止,停下來的位置就是共同開頭最長的地方;再從那裡往下收一個完整的字接上去,就是修正建議。
拿主例的 Trie 試一次,使用者打了 ratt,程式走 r、a 都走得到,第三個字母 t 在 a 的 children 裡找不到(那裡只有 r),於是停在 ra。從 ra 往下收得到 re,接起來就是 rare。
程式碼如下:
autocorrect(word) {
  let current = this.root;
  let found = '';

  for (const char of word) {
    if (current.children[char] === undefined) { // 走不下去了,就地把剩下的補完
      return found + this.collectWords(current, '', [])[0];
    }
    found += char;
    current = current.children[char];
  }

  return word; // 整個字都走得完,代表它本來就在 Trie 裡,不必修正
}
和 search 的差異在於走不下去時不回傳 null,而是就地把剩下的部分補完。而如果整個字都走得完,代表它本來就在 Trie 裡,那就直接回傳它、不必修正,這也是 autocorrect 和 autocomplete 的差異:同樣走到那顆 node,autocomplete 會把底下所有的字都列出來,autocorrect 只要一個。
這做法有些邊界,第一個是共同開頭一樣長的時候,例如使用者打了 aq,程式在 a 就走不下去,而 are、as、at 和它共同的開頭都只有 a 這個字母,回傳哪個都可以。第二個更極端,如果第一個字母就打錯,程式在 root 就走不下去,共同開頭是空的,收上來的會是整份字典裡的某一個字,那就沒辦法提供有用的建議了。
小小總結一下今天對 Trie 的認識~
rare 最多還是處理四個字母;要找以某段字首開頭的所有單字時,先找到字首對應的 node,再走訪它底下的 subtree 即可。實際使用時,還可以記住幾件事~
r → a 這條路徑,只能說明 ra 是某個單字的字首;要判斷 ra 自己是不是完整單字,還要檢查 isEndOfWord
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術